L'autoencodeur : compresser sans perdre l'essentiel
Introduction
Est-ce que toutes les informations d’une image sont utiles ? Est-ce qu’on peut enlever de l’information sans altérer la qualité d’une image ? Dans ce billet, on va parler de compression et de génération d’image et on va aborder l’autoencodeur.
Un autoencodeur est un réseau de neurones entraîné à reproduire sa propre entrée en sortie, après être passé par un goulot d’étranglement interne : une représentation de dimension beaucoup plus réduite que la donnée d’origine. L’exercice serait trivial sans cette contrainte. Avec elle, le réseau est forcé de faire un choix à chaque exemple : que garder, que jeter.
C’est une des briques les plus anciennes et les plus simples du deep learning, et elle reste pourtant au cœur de nombreuses applications actuelles : réduction de dimension pour visualiser des données complexes, débruitage d’images ou de signaux, pré-entraînement de réseaux profonds, détection d’anomalies (une donnée mal reconstruite est probablement atypique), et brique de départ de modèles génératifs plus avancés comme le VAE.
Ce billet part d’à peu près zéro : pourquoi comprimer une donnée sans rien perdre d’essentiel, comment un réseau peut apprendre ça sans aucune supervision, quel est le lien exact avec des méthodes plus anciennes comme la PCA, et où se situe la limite précise qui empêche un autoencodeur classique de générer de nouvelles données.
A la fin de ce post, on ira un peu plus loin et on mettra les pieds dans le formalisme mathématique sous-jacent.
1. Petite comparaison pour commencer : Une corde qui vibre
Prends une corde de guitare pincée. Sa forme, à un instant donné, est en théorie décrite par une infinité de nombres : la hauteur de chaque point de la corde. En pratique, son mouvement s’explique presque entièrement par l’amplitude de ses trois ou quatre premiers modes propres de vibration, le fondamental et quelques harmoniques. Le reste de l’information est négligeable.
Décrire la corde par ces quelques amplitudes plutôt que par la position de chaque point est une compression. Ce n’est pas une approximation grossière : c’est un changement de système de coordonnées, choisi précisément pour que l’essentiel du mouvement tienne dans peu de nombres. C’est cette idée, transposée aux données, qu’implémente un autoencodeur.
2. Le problème concret
Prends un tout petit exemple avant de passer aux images réelles. Un patch de $4\times4$ pixels représentant un coin de ciel nocturne, tous à peu près à la même valeur, disons $230$ sur une échelle de $0$ à $255$, avec de petites variations de bruit. Pour le stocker tel quel, il faut $16$ nombres. Mais si je te dis seulement « valeur autour de $230$, sur toute la zone », tu peux reconstruire ce patch presque parfaitement. Les $16$ nombres ne contenaient pas $16$ informations différentes, ils contenaient presque la même information répétée $16$ fois.
C’est exactement ce qui se passe, en beaucoup plus subtil, sur une image réelle. Une image de $64\times64$ pixels en trois couleurs contient $12\,288$ nombres, mais elle ne contient pas $12\,288$ informations indépendantes : deux pixels voisins sont presque toujours proches en valeur, un fond de ciel occupe souvent une bonne partie de l’image avec une teinte quasiment uniforme, une structure comme un bras de galaxie s’étend sur des dizaines de pixels corrélés entre eux plutôt que de varier au hasard d’un pixel à l’autre.
La question devient alors : combien de nombres faut-il vraiment, et comment le réseau peut-il apprendre lui-même lesquels garder, sans qu’on le lui dise à l’avance ?
3. Deux fonctions, un seul objectif
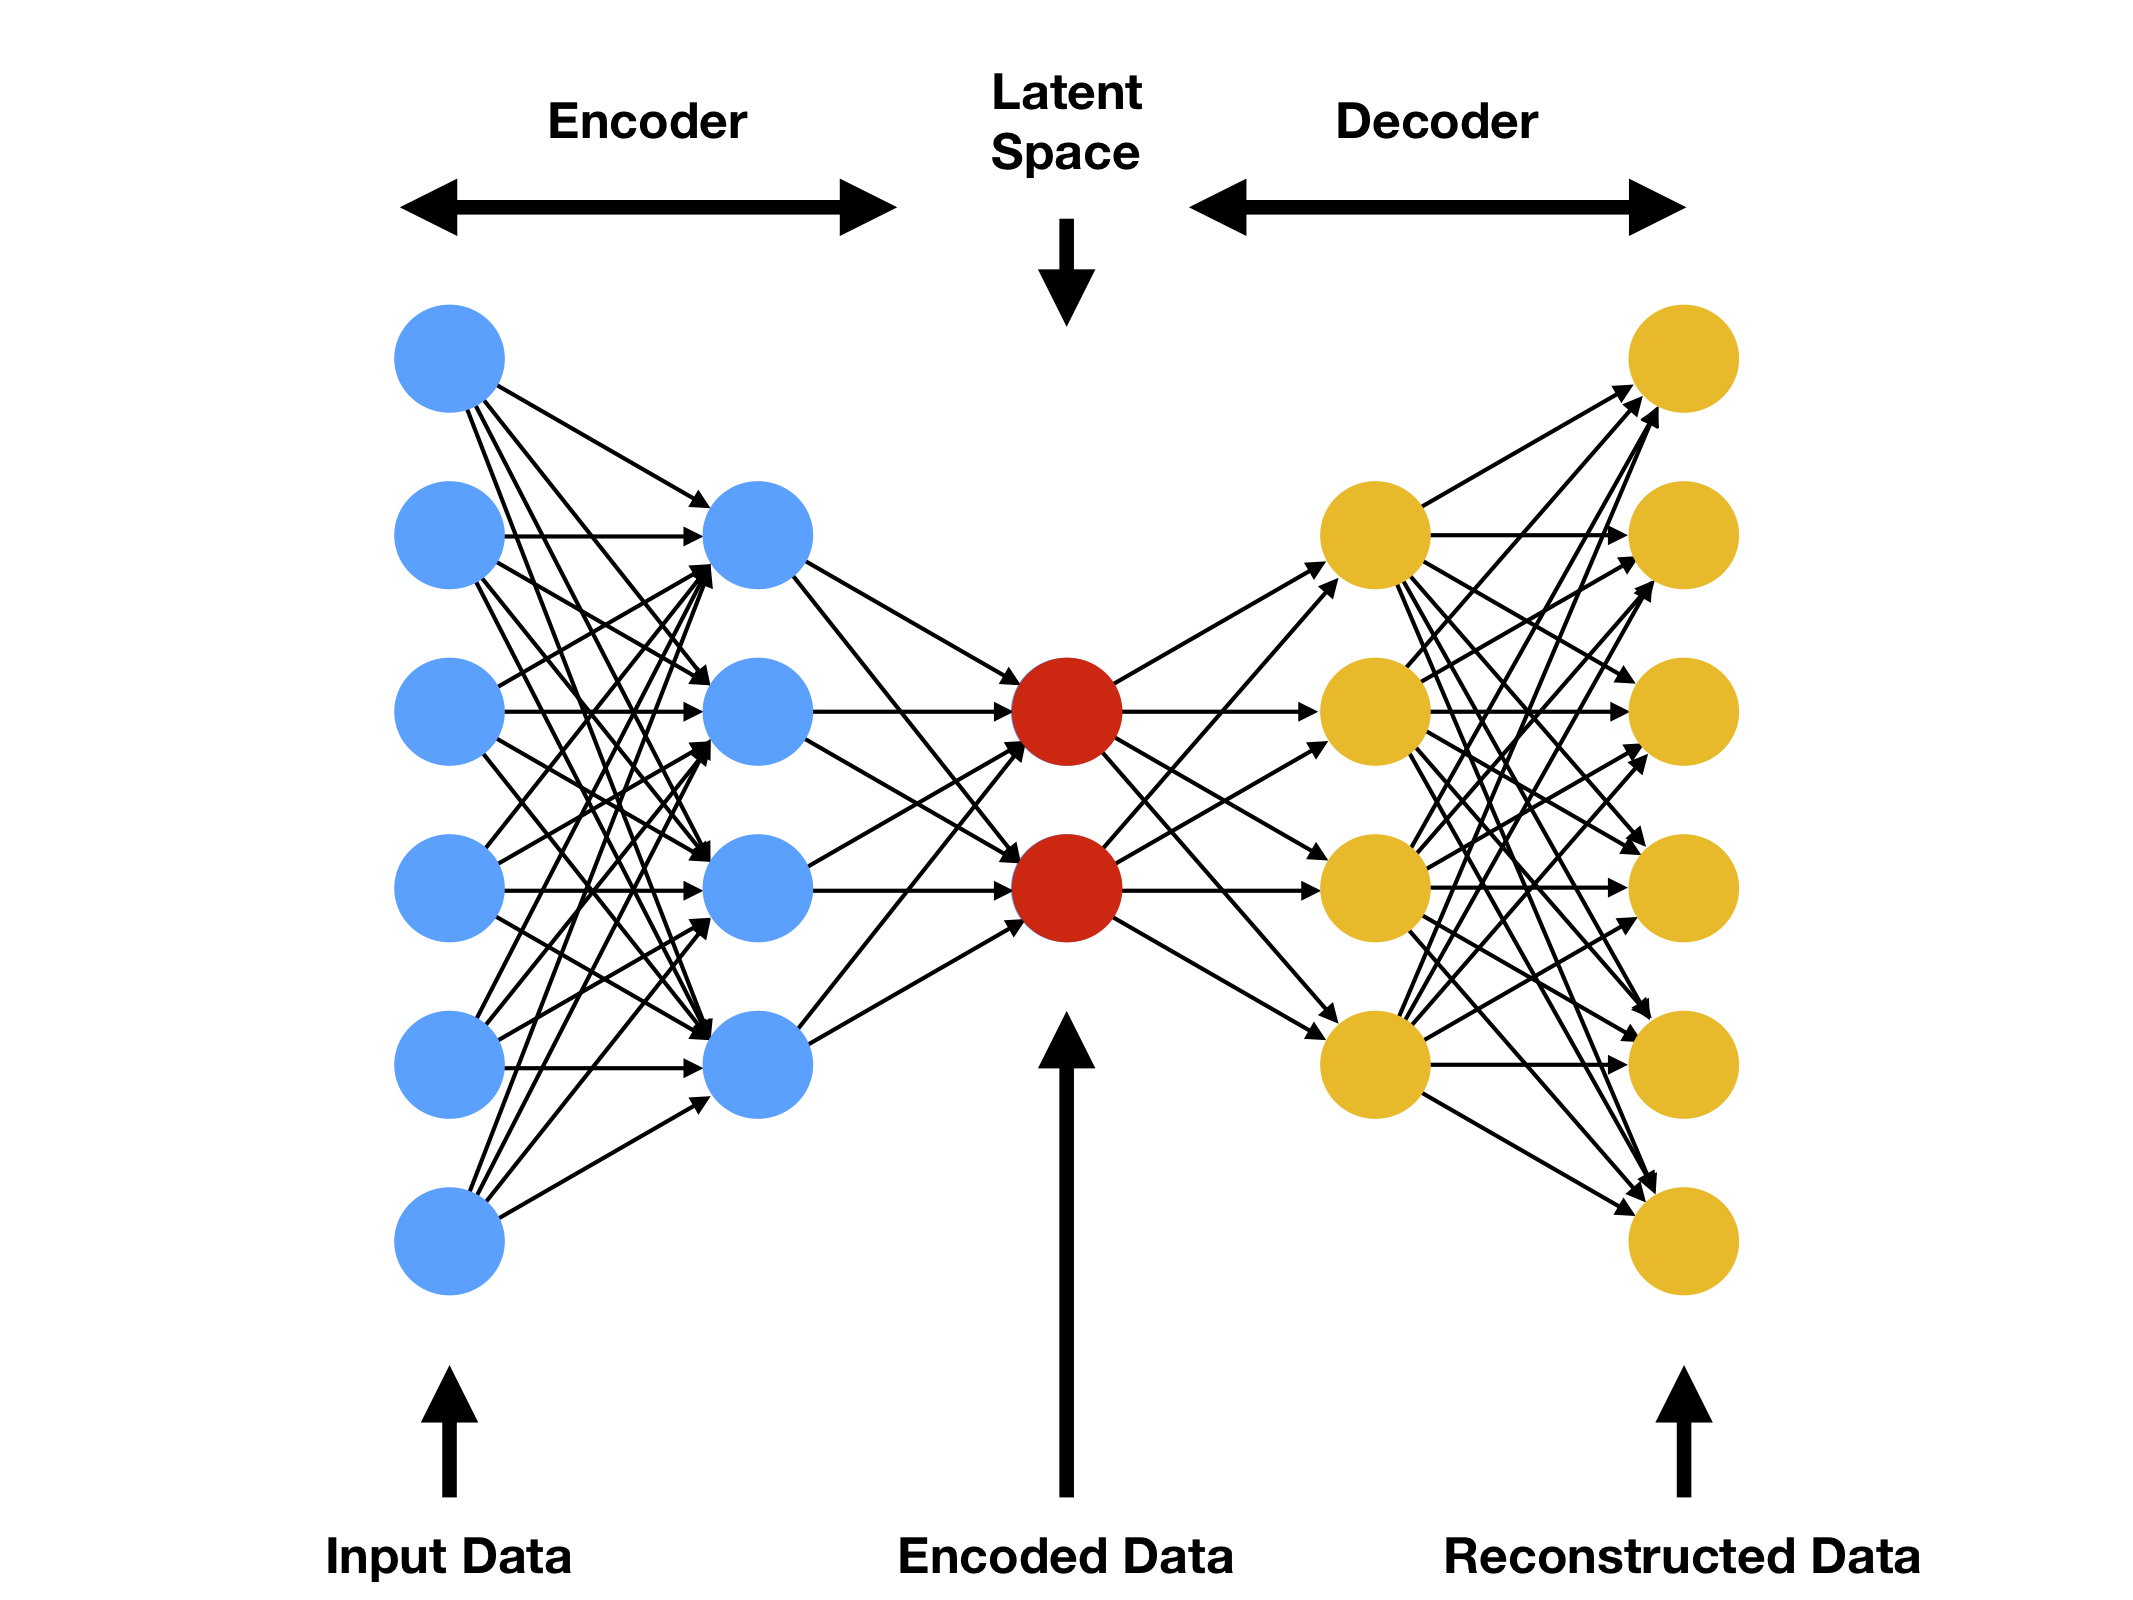
Un autoencodeur est constitué de deux réseaux entraînés ensemble :
- un encodeur $f$ qui prend une donnée $\mathbf{x}$ et produit un code $\mathbf{z} = f(\mathbf{x})$, de dimension beaucoup plus petite que $\mathbf{x}$
- un décodeur $g$ qui prend $\mathbf{z}$ et produit une reconstruction $\hat{\mathbf{x}} = g(\mathbf{z})$
Le vecteur $\mathbf{z}$ est appelé représentation latente. Sa dimension est fixée à l’avance, volontairement petite, ce qui force le réseau à compresser plutôt qu’à recopier purement et simplement l’entrée.
L’entraînement ne repose que sur une seule perte, l’erreur de reconstruction :
\[\mathcal{L}(\mathbf{x}) = \|\mathbf{x} - g(f(\mathbf{x}))\|^2\]Aucun label n’est nécessaire. La donnée d’entrée sert elle-même de cible : c’est un apprentissage non supervisé.
4. Pourquoi ça marche sans qu’on le lui impose explicitement
Rien, dans cette perte, ne dit explicitement au réseau comment organiser l’espace des $\mathbf{z}$. Et pourtant, deux images qui se ressemblent finissent presque toujours avec des codes proches. La raison est indirecte : si deux images différentes recevaient le même $\mathbf{z}$, le décodeur ne pourrait pas les reconstruire correctement toutes les deux, ce qui ferait monter la perte. Une pression implicite pousse donc les données similaires vers des codes similaires. C’est un effet de bord de la reconstruction, pas une propriété garantie.
5. Le cas linéaire, et sa preuve mathématique
Si l’encodeur et le décodeur sont tous deux linéaires, une seule couche, sortie sans activation, et que la perte est l’erreur quadratique, Bourlard & Kamp (1988) ont démontré que le sous-espace de dimension réduite appris par le réseau est exactement le même que celui obtenu par une décomposition en valeurs singulières (SVD), donc équivalent à une analyse en composantes principales (PCA). Reprends l’image de la corde : c’est le même résultat que projeter le mouvement sur ses modes propres dominants, obtenu ici par descente de gradient plutôt que par diagonalisation directe.
6. Le cas non linéaire, et pourquoi il change tout
Une SVD ne peut découvrir que des sous-espaces linéaires. Beaucoup de structures réelles ne le sont pas : imagine une donnée qui se répartit le long d’une courbe enroulée en spirale dans un espace de grande dimension, aucune projection linéaire ne peut la dérouler proprement.
Hinton & Salakhutdinov (2006) ont montré qu’un autoencodeur profond, avec des activations non linéaires dans l’encodeur et le décodeur, apprend un changement de coordonnées non linéaire, capable de dérouler ce genre de structure. C’est ce résultat, publié dans Science, qui a relancé l’intérêt pour les autoencodeurs et posé les bases de leur usage moderne en apprentissage profond.
7. Implémentation : encodeur et décodeur séparés
Le schéma de la section 3 montrait un autoencodeur pleinement connecté, où chaque neurone d’une couche est relié à tous les neurones de la suivante.
7.1 L’achitecture de l’autoencodeur convolutif
L’implémentation ci-dessous en est une variante convolutive, mieux adaptée aux images : la compression et la reconstruction spatiales se font par convolutions plutôt que par des couches entièrement connectées.
Avant le code, un rappel bref du rôle de chaque couche utilisée :
-
Conv2d(convolution) : fait glisser un petit filtre sur l’image pour détecter des motifs locaux (contours, textures). Avec unstridede 2, elle réduit aussi la résolution spatiale d’un facteur 2 à chaque passage, c’est le mécanisme qui fait la compression spatiale dans l’encodeur. -
ReLU: une non-linéarité, $\max(0, x)$. Sans elle, empiler plusieurs convolutions reviendrait à n’en faire qu’une seule linéaire (section 6). -
Linear(couche pleinement connectée) : après les convolutions, elle prend le résultat aplati et le projette dans l’espace latent de dimension choisie. C’est la seule couche qui fixe explicitement la taille de l’espace latent $\mathbf{z}$. -
ConvTranspose2d(convolution transposée) : l’opération symétrique deConv2davecstride, elle augmente la résolution spatiale au lieu de la réduire. C’est elle qui permet au décodeur de repasser d’un petit tenseur à la taille de l’image d’origine. -
Sigmoid: borne la sortie du décodeur dans $[0, 1]$, pour qu’elle soit comparable aux pixels normalisés de l’image d’entrée.
J’ai volontairement séparé les deux réseaux en deux classes distinctes, plutôt que de tout empiler dans une seule. C’est un peu plus verbeux, mais ça rend explicite ce qui est symétrique entre les deux, et ça permet de réutiliser l’encodeur seul une fois entraîné (par exemple pour extraire des descripteurs).
import torch
import torch.nn as nn


class Encoder(nn.Module):
    """Convolutional encoder mapping an image to a latent vector."""

    def __init__(self, latent_dim):
        super().__init__()
        self.conv = nn.Sequential(
            nn.Conv2d(1, 32, kernel_size=3, stride=2, padding=1),
            nn.ReLU(),
            nn.Conv2d(32, 64, kernel_size=3, stride=2, padding=1),
            nn.ReLU(),
        )
        self.fc = nn.Linear(64 * 7 * 7, latent_dim)

    def forward(self, x):
        h = self.conv(x)
        h = h.flatten(start_dim=1)
        z = self.fc(h)
        return z


class Decoder(nn.Module):
    """Convolutional decoder mapping a latent vector back to an image."""

    def __init__(self, latent_dim):
        super().__init__()
        self.fc = nn.Linear(latent_dim, 64 * 7 * 7)
        self.deconv = nn.Sequential(
            nn.ConvTranspose2d(64, 32, kernel_size=3, stride=2, padding=1, output_padding=1),
            nn.ReLU(),
            nn.ConvTranspose2d(32, 1, kernel_size=3, stride=2, padding=1, output_padding=1),
            nn.Sigmoid(),
        )

    def forward(self, z):
        h = self.fc(z)
        h = h.view(-1, 64, 7, 7)
        x_hat = self.deconv(h)
        return x_hat


class Autoencoder(nn.Module):
    """Autoencoder combining a separately defined encoder and decoder."""

    def __init__(self, latent_dim):
        super().__init__()
        self.encoder = Encoder(latent_dim)
        self.decoder = Decoder(latent_dim)

    def forward(self, x):
        z = self.encoder(x)
        x_hat = self.decoder(z)
        return x_hat, z
Retire les deux nn.ReLU() de l’encodeur, remplace les convolutions par des couches linéaires, et l’ensemble devient strictement linéaire. D’après Bourlard & Kamp, il convergera alors vers le même sous-espace qu’une PCA sur les mêmes données. Le notebook associé à ce billet reprend cette implémentation sur FashionMNIST, avec les courbes d’apprentissage et une visualisation de l’espace latent.
Remarque: Dans notre exemple, l’encodeur et le décodeur sont symétriques mais il existe des versions asymétriques selon l’objectif poursuivi (apprentissage autosupervisé par masquage, compression d’images, image -> texte,…)
Quelques plots pour se faire une idée
J’ai executé le notebook associé. J’ai mis une dimension d’espace latent de 2 et l’entrainement à tourné pendant 20 époques. Il est certain que le résultat n’est pas optimal. Je vous laisserai jouer avec le notebook si vous souhaitez améliorer le résultat.
Quelques reconstructions après entrainement
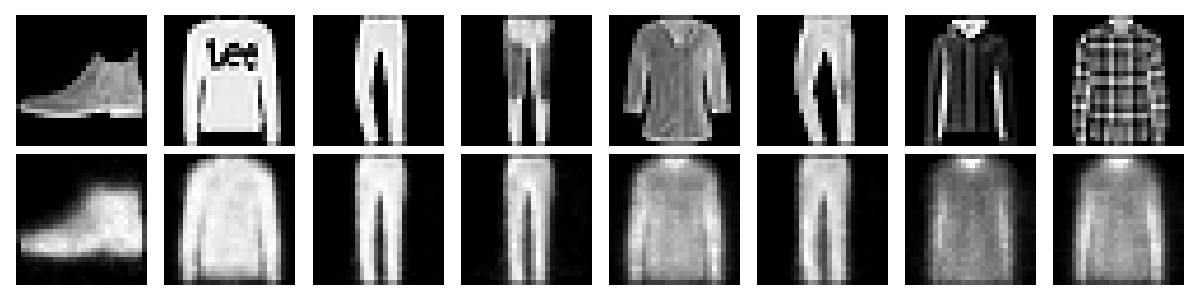
Avec une dimension latente de 2, l’autoencodeur ne dispose que de deux nombres pour décrire chaque image de 784 pixels. Le résultat est cohérent avec cette contrainte : la classe du vêtement et sa silhouette générale sont correctement restituées, ce qui montre que ces deux nombres encodent bien une information de forme globale, mais tout ce qui relève de la texture ou du détail local, comme le texte « Lee » sur le pull en position 2, est entièrement perdu.
Représentation de l’espace latent
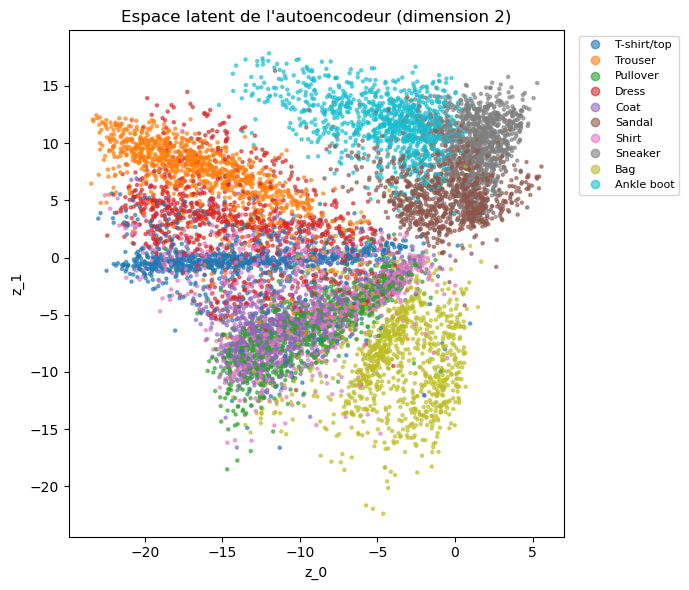
Bien que l’autoencodeur n’ait jamais eu accès aux étiquettes de classe pendant l’entraînement, la structure de l’espace latent reflète déjà une bonne partie de cette organisation, exactement l’effet indirect décrit en section 4 : deux images qui se ressemblent reçoivent des représentations latentes proches parce que le décodeur ne peut pas les reconstruire correctement autrement. Le pantalon, les chaussures et le sac ont des silhouettes suffisamment distinctes pour se séparer même avec seulement deux dimensions. À l’inverse, T-shirt, pull, manteau et chemise partagent une silhouette générale très proche (un rectangle avec deux manches), et se chevauchent dans l’espace latent : deux nombres ne suffisent pas à encoder la texture ou la coupe qui les distingue réellement. C’est le même goulot d’étranglement que celui observé sur les reconstructions individuelles.
Note : Pour construire ce nuage de points, chaque image du jeu de test est passée uniquement dans l’encodeur, pas dans l’autoencodeur complet, afin d’obtenir sa représentation latente $(z_0, z_1)$. Ces deux nombres deviennent directement les coordonnées du point correspondant dans le plan. La couleur de chaque point indique la catégorie réelle du vêtement, une information que le modèle n’a jamais vue pendant l’entraînement : elle sert uniquement, ici, à vérifier après coup si des vêtements visuellement proches se retrouvent proches dans l’espace latent.
8. La limite qu’il faut garder en tête
L’espace latent d’un autoencodeur classique n’est ni continu de façon garantie, ni de forme connue à l’avance. Si on tire un $\mathbf{z}$ au hasard et qu’on le passe dans le décodeur, on obtient le plus souvent une image incohérente : rien ne garantit que ce point tombe dans une zone que le décodeur a réellement apprise. L’autoencodeur compresse bien. Il ne génère pas.
C’est exactement le problème que le VAE va résoudre, en changeant non pas l’architecture, mais ce qu’on force l’espace latent à devenir. Ce sera le sujet du prochain billet de la série, après un détour par les GAN.
9. Formalisation générale et variantes avancées
Petit ajout 2026 :
Les sections précédentes ont présenté un cas particulier, celui de l’autoencodeur convolutif. On a vaguement abordé d’autres architectures possible.
Pour le formaliser, il est utile de poser le problème sous une forme plus générale, celle qui sert de socle commun à la plupart des variantes de l’autoencodeur, VAE compris. On va brièvement plonger dans le formalisme mathématique. Pour s’aider, j’ai repris, dans le même ordre, le traitement qu’en fait Goodfellow, et al. dans leur livre Deep Learning (MIT Press, 2016), chapitre 14.
9.1 Autoencodeur sous-complet
Un autoencodeur est dit sous-complet lorsque la dimension du code $\mathbf{z} = f(\mathbf{x})$ est strictement plus petite que celle de l’entrée. L’apprentissage consiste à minimiser une fonction de loss générique
\[L\big(\mathbf{x}, g(f(\mathbf{x}))\big),\]où $L$ pénalise la “dissemblance” entre $\mathbf{x}$ et sa reconstruction, typiquement l’erreur quadratique. C’est exactement l’autoencodeur présenté en section 3. Si le décodeur est linéaire et $L$ l’erreur quadratique, l’espace appris coïncide avec le sous-espace principal obtenu par PCA (section 5). Sans la contrainte $\dim(\mathbf{z}) < \dim(\mathbf{x})$, rien n’empêche le réseau d’apprendre l’identité.
9.2 Autoencodeurs régularisés
Plutôt que de forcer la compression uniquement par la taille de l’espace latent, on peut garder un latent de grande dimension, y compris de dimension supérieure à l’entrée (autoencodeur sur-complet), et forcer une propriété utile par un terme de régularisation $\Omega$ ajouté à la perte :
\[L\big(\mathbf{x}, g(f(\mathbf{x}))\big) + \Omega(\mathbf{z})\]C’est ce cadre, et le choix de $\Omega$, qui distingue les variantes suivantes.
9.3 Autoencodeur parcimonieux
$\Omega$ pénalise ici l’activation du latent, pour qu’un exemple donné n’active qu’un petit nombre de neurones. Deux réalisations courantes :
Pénalité $L_1$ directe sur les activations : $\Omega(\mathbf{z}) = \lambda \sum_j |z_j|$
Pénalité par divergence de Kullback-Leibler entre l’activation moyenne observée $\hat{\rho}_j$ d’un neurone sur le jeu de données et une parcimonie cible $\rho$ fixée à l’avance (proche de 0) :
Dans les deux cas, le réseau est forcé à ne conserver, pour chaque exemple, qu’un sous-ensemble restreint de neurones actifs.
9.4 Autoencodeur débruiteur
Une approche différente : au lieu de pénaliser le latent, on corrompt volontairement l’entrée. Le réseau reçoit une version bruitée $\tilde{\mathbf{x}}$ de $\mathbf{x}$ (par exemple $\tilde{\mathbf{x}} = \mathbf{x} + \varepsilon$) et doit reconstruire l’original propre :
\[L\big(\mathbf{x}, g(f(\tilde{\mathbf{x}}))\big).\]Le réseau ne peut plus se contenter de recopier son entrée, il doit apprendre à quoi ressemble la structure réelle des données pour pouvoir en retirer le bruit. Vincent et al. (2008) montrent que cette approche revient à approcher $-\log p_{\text{decoder}}(\mathbf{x} \mid \mathbf{z} = f(\tilde{\mathbf{x}}))$, une lecture probabiliste explicite de l’objectif de reconstruction.
9.5 Autoencodeur contractant
Ici $\Omega$ dépend à la fois du latent et de l’entrée, $\Omega(\mathbf{z}, \mathbf{x})$, et pénalise la sensibilité du latent à de petites perturbations de l’entrée, via la norme de Frobenius de la matrice jacobienne de l’encodeur par rapport à $\mathbf{x}$ :
\[\Omega(\mathbf{z}, \mathbf{x}) = \lambda \sum_j \left\| \nabla_{\mathbf{x}} z_j \right\|^2.\]Rifai et al. (2011) montrent que cette pénalité produit une contraction localisée de l’espace des représentations autour des points d’entraînement, ce qui rend la représentation latente robuste au bruit sans avoir besoin de corrompre explicitement l’entrée comme le fait l’autoencodeur débruiteur.
9.6 Petite remarque pour finir
Ces trois variantes montrent que $\Omega$ peut encoder des propriétés très différentes : parcimonie, robustesse au bruit, insensibilité locale. Le VAE, présenté dans un prochain billet, se lit dans ce même cadre général : son terme $\mathcal{L}_{\mathrm{KL}}$ est un choix particulier de régularisation, celui qui pousse la distribution du code vers $\mathcal{N}(0, I)$ plutôt que vers la parcimonie ou la contraction. Le VAE n’est pas une rupture avec l’autoencodeur régularisé, il en est un cas particulier.
Références
-
Bourlard, H. & Kamp, Y. (1988). Auto-association by multilayer perceptrons and singular value decomposition. Biological Cybernetics, 59(4-5), 291-294. doi:10.1007/BF00332918
-
Hinton, G. E. & Salakhutdinov, R. R. (2006). Reducing the Dimensionality of Data with Neural Networks. Science, 313(5786), 504-507. doi:10.1126/science.1127647
-
Kingma, D. P., & Welling, M. (2013). Auto-Encoding Variational Bayes. ICLR 2014. arXiv:1312.6114
-
Goodfellow, I., et al. (2014). Generative Adversarial Networks. NeurIPS 2014. arXiv:1406.2661
-
Goodfellow, Bengio & Courville, Deep Learning, chapitre 14
-
Rifai, S., Vincent, P., Muller, X., Glorot, X., & Bengio, Y. (2011). Contractive Auto-Encoders: Explicit Invariance During Feature Extraction. Proceedings of the 28th International Conference on Machine Learning (ICML), 833-840.
Enjoy Reading This Article?
Here are some more articles you might like to read next: