Les autoencodeurs variationnels (VAE)
Introduction
Il y a quelques mois, j’avais écrit un billet sur l’autoencodeur et il se terminait sur un point précis : son espace latent n’a ni continuité garantie, ni forme connue à l’avance. Autrement dit, tirer un vecteur au hasard et le décoder produit, le plus souvent, une image incohérente. L’autoencodeur compresse bien, mais il ne génère pas. Il nous faut une alternative.
Le VAE (Variational Autoencoder) de Kingma & Welling 2013 résout exactement ce problème, sans changer l’architecture encodeur/décodeur qu’on a déjà vue: il change le devenir de l’espace latent. Dans cette article, on a essayer de dérouler le raisonnement mathématique complet qui mène à cette solution. Par contre, il faut s’attendre à un peu de maths.
1. Le principe de base du VAE
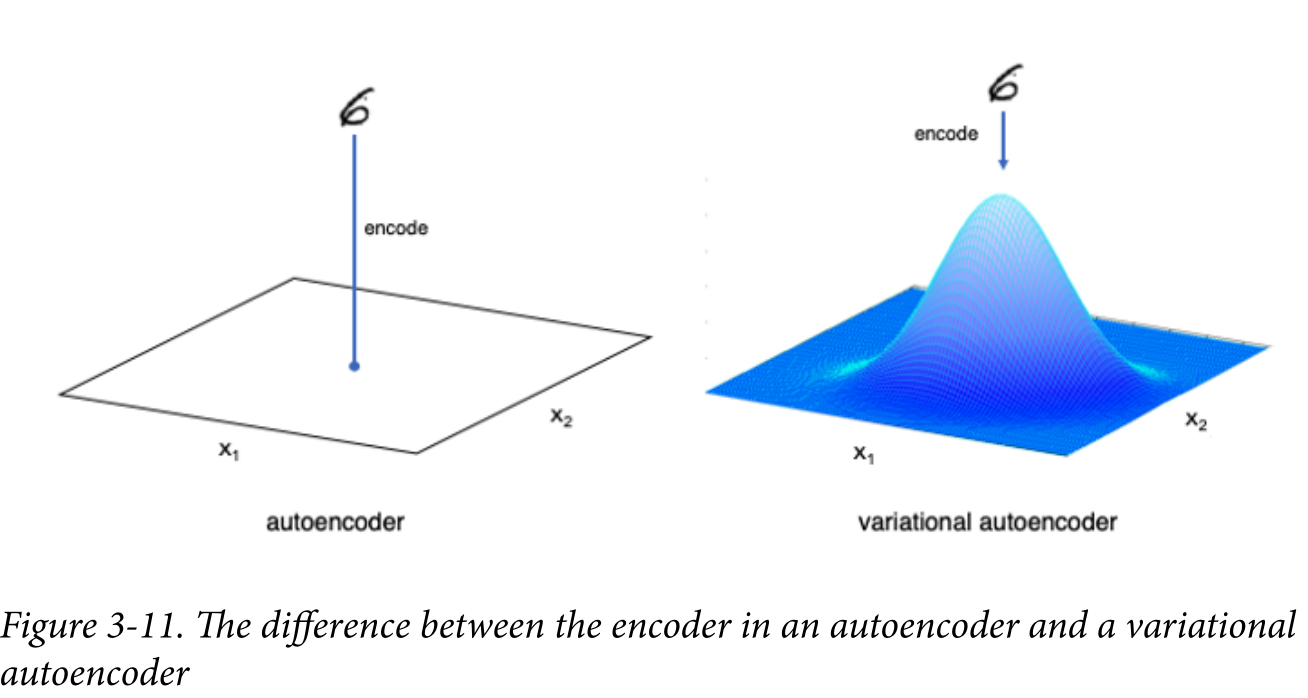
Qui a fait un peu de théorie de la mesure, c’est qu’une mesure physique n’est jamais un simple nombre. Une température, une amplitude sismique, une distance : c’est une valeur ET son incertitude, $\mu \pm \sigma$. Au quotidien, on ne considère pas trop ce $\sigma$ mais en en réalité, ce pas un détail secondaire, c’est une information à part entière, qui nous dit à quel point on peut faire confiance à la valeur $\mu$.
C’est ce choix que fait le VAE pour chaque donnée qu’il encode : plutôt que de produire un point unique $\mathbf{z}$, comme le fait l’autoencodeur, il produit une valeur ET une incertitude, $\boldsymbol{\mu}$ et $\boldsymbol{\sigma}^2$
2. Reformuler le problème : un modèle génératif de $\mathbf{x}$
L’autoencodeur apprenait deux fonctions, $f$ et $g$, sans qu’aucune des deux ne soit une distribution de probabilité explicite. Pour construire un modèle génératif rigoureux, il faut changer de langage et repartir d’un modèle probabiliste des données.
Deux variables interviennent désormais : $\mathbf{x}$, la donnée observée, une image réelle du jeu de données, et $\mathbf{z}$, une variable latente, un vecteur jamais observé directement.
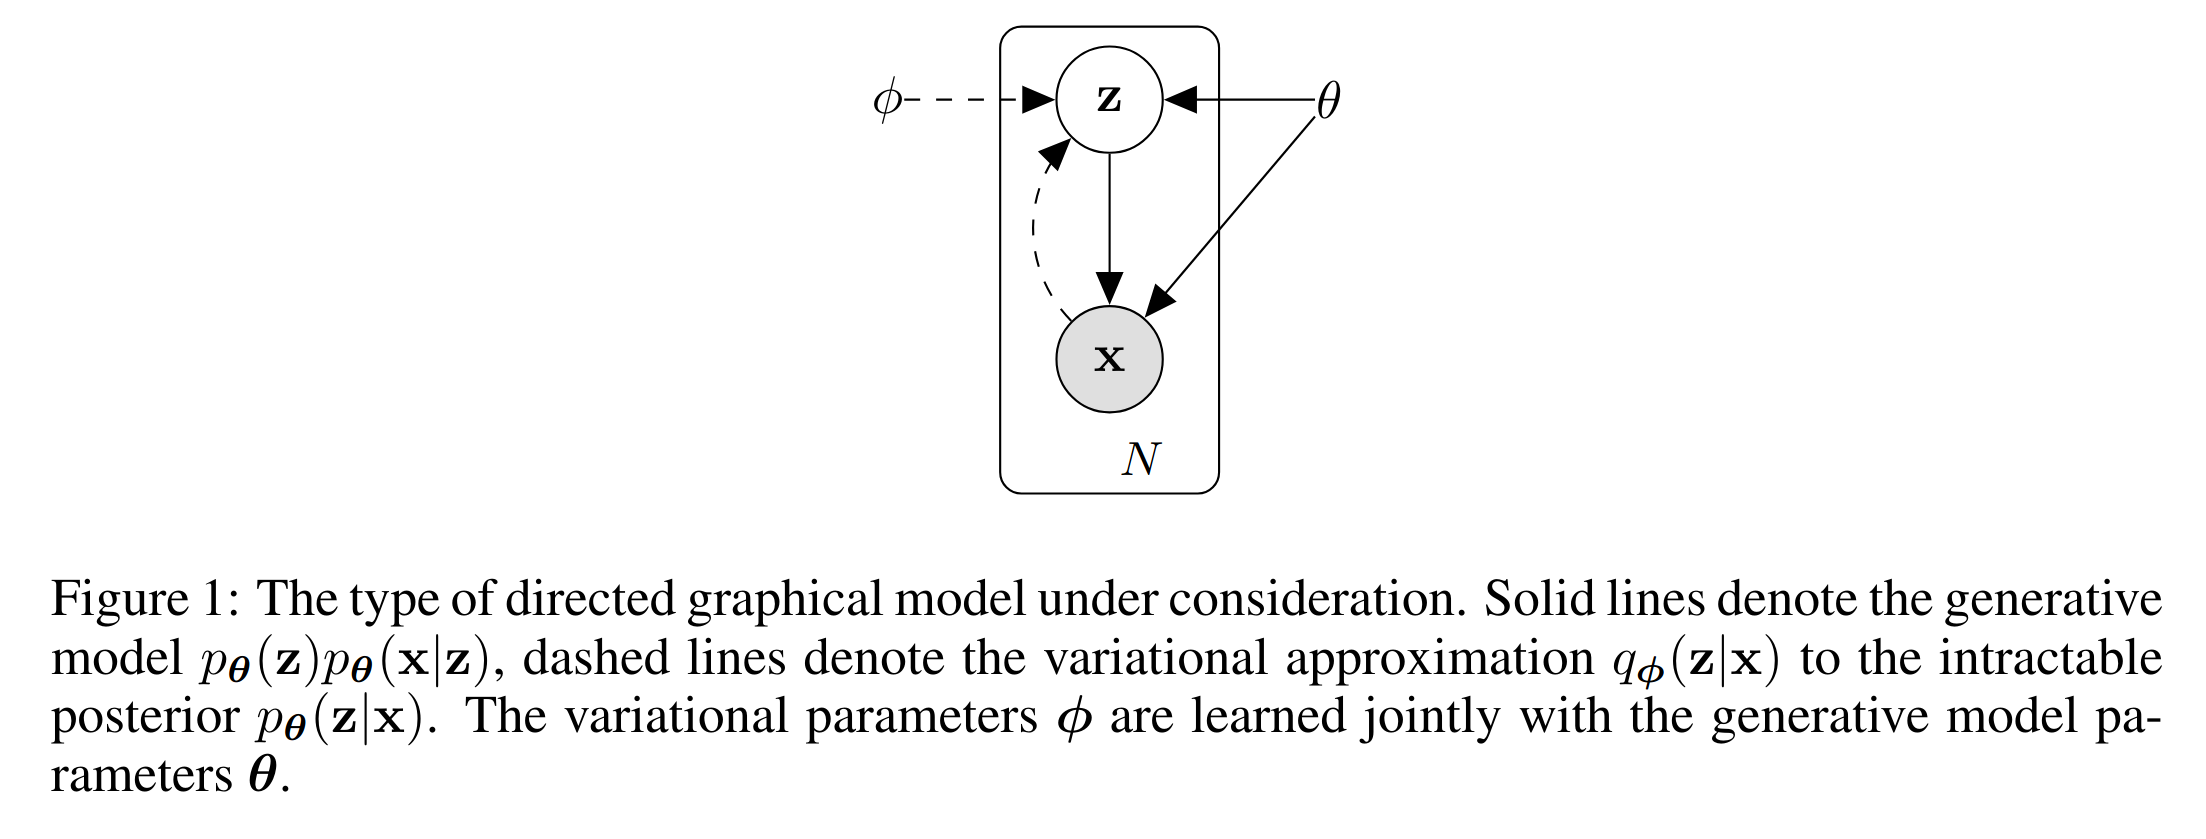
Pour rendre le problème traitable, on choisit de décrire chaque donnée $\mathbf{x}$ comme si elle avait été produite en deux temps. Ce n’est pas une affirmation sur la façon dont les vraies images ont été prises, c’est une fiction mathématique utile, un choix de modélisation qui va nous permettre de construire un objet calculable :
- une variable latente $\mathbf{z}$, un vecteur, est tirée selon une loi a priori simple, $\mathbf{z} \sim p(\mathbf{z}) = \mathcal{N}(0, I)$
- $\mathbf{x}$ est ensuite généré à partir de $\mathbf{z}$ selon une loi conditionnelle $p_\theta(\mathbf{x} \mid \mathbf{z})$, paramétrée par un réseau de neurones, le décodeur.
La probabilité marginale d’observer $\mathbf{x}$ sous ce modèle, celle qu’on voudrait maximiser sur le jeu de données, s’obtient en intégrant sur toutes les valeurs possibles de $\mathbf{z}$ :
\[p_\theta(\mathbf{x}) = \int p_\theta(\mathbf{x} \mid \mathbf{z})\, p(\mathbf{z})\, d\mathbf{z}.\]Cette intégrale est le cœur du problème…
Autrement dit : plutôt que de choisir un $\mathbf{z}$ unique pour expliquer $\mathbf{x}$, on considère chaque $\mathbf{z}$ possible comme une explication candidate, pondérée par deux choses, sa plausibilité a priori $p(\mathbf{z})$ et sa capacité à effectivement produire $\mathbf{x}$, $p_\theta(\mathbf{x} \mid \mathbf{z})$. L’intégrale additionne ces contributions sur tout l’espace latent.
3. L’inférence variationnelle
Cette intégrale, en toute généralité, ne peut pas être calculée avec une formule mathématique exacte. Deux raisons à cela, chacune suffisante à elle seule.
-
$p_\theta(\mathbf{x} \mid \mathbf{z})$ est calculée par un réseau de neurones, empilement de plusieurs couches et non-linéarités. Contrairement à une fonction simple comme un polynôme ou une gaussienne, il n’existe aucune formule connue pour intégrer ce genre de fonction à la main.
-
Raison plus profonde, même en renonçant à une formule exacte et en essayant d’estimer cette intégrale numériquement, en tirant des $\mathbf{z}$ au hasard et en moyennant, la méthode échoue presque à coup sûr. L’immense majorité des $\mathbf{z}$ tirés au hasard donnent une probabilité $p_\theta(\mathbf{x} \mid \mathbf{z})$ quasiment nulle, et ne contribuent presque rien à la somme, quel que soit le nombre de tirages.
On pourrait être tenté de passer par la distribution a posteriori en utilisant la loi de Bayes :
\[p_\theta(\mathbf{z} \mid \mathbf{x}) = \frac{p_\theta(\mathbf{x} \mid \mathbf{z})\, p(\mathbf{z})}{p_\theta(\mathbf{x})},\]mais elle contient justement $p_\theta(\mathbf{x})$ au dénominateur, le terme qu’on n’arrive pas à calculer. On tourne en rond : il faut $p_\theta(\mathbf{z} \mid \mathbf{x})$ pour calculer $p_\theta(\mathbf{x})$, et il faut $p_\theta(\mathbf{x})$ pour calculer $p_\theta(\mathbf{z} \mid \mathbf{x})$.
L’idée centrale de l’inférence variationnelle, reprise par Kingma & Welling (2013) :
Plutôt que de calculer $p_\theta(\mathbf{z} \mid \mathbf{x})$ exactement, on l’approche par une distribution plus simple $q_\phi(\mathbf{z} \mid \mathbf{x})$, elle-même produite par un réseau de neurones, l’encodeur. C’est ce réseau $q_\phi$ qui va jouer, dans le VAE, le rôle que jouait $f$ dans l’autoencodeur.
4. La borne inférieure variationnelle (ELBO)
Entraîner ce modèle consiste à ajuster $\theta$ pour maximiser la probabilité que le modèle attribue aux vraies données du jeu d’entraînement, le principe usuel du maximum de vraisemblance. En pratique, on travaille avec le logarithme de cette probabilité plutôt qu’avec la probabilité elle-même : pour un jeu de données de $N$ exemples indépendants, la vraisemblance totale est un produit $\prod_i p_\theta(\mathbf{x}i)$, numériquement instable dès que $N$ grandit, alors que le logarithme la transforme en une somme, $\sum_i \log p\theta(\mathbf{x}_i)$, sans changer l’endroit où se trouve le maximum, puisque le logarithme est strictement croissant.
Donc, on va calculer $\log p_\theta(\mathbf{x})$. Et si on ne peut pas le faire directement, on peut en construire une approximation calculable, en réintroduisant justement le $q_\phi(\mathbf{z} \mid \mathbf{x})$ qu’on vient d’évoquer :
Partons de $\log p_\theta(\mathbf{x})$ et introduisons $q_\phi(\mathbf{z} \mid \mathbf{x})$ artificiellement, en multipliant et divisant par la même quantité à l’intérieur de l’intégrale :
\[\log p_\theta(\mathbf{x}) = \log \int p_\theta(\mathbf{x} \mid \mathbf{z})\, p(\mathbf{z})\, d\mathbf{z} = \log \, \mathbb{E}_{\mathbf{z} \sim q_\phi(\mathbf{z} \mid \mathbf{x})} \!\left[ \frac{p_\theta(\mathbf{x} \mid \mathbf{z})\, p(\mathbf{z})}{q_\phi(\mathbf{z} \mid \mathbf{x})} \right].\]Détail du calcul
Cette égalité se construit en trois étapes :
Multiplier et diviser par $q_\phi(\mathbf{z} \mid \mathbf{x})$. On insère cette quantité au numérateur et au dénominateur à l’intérieur de l’intégrale, une opération qui ne change rien puisqu’elle revient à multiplier par 1 :
\[p_\theta(\mathbf{x}) = \int p_\theta(\mathbf{x} \mid \mathbf{z})\, p(\mathbf{z})\, d\mathbf{z} = \int \frac{p_\theta(\mathbf{x} \mid \mathbf{z})\, p(\mathbf{z})}{q_\phi(\mathbf{z} \mid \mathbf{x})} \, q_\phi(\mathbf{z} \mid \mathbf{x}) \, d\mathbf{z}.\]Cette opération suppose que $q_\phi(\mathbf{z} \mid \mathbf{x})$ ne s’annule jamais là où $p_\theta(\mathbf{x} \mid \mathbf{z})\,p(\mathbf{z})$ est non nul, sous peine de diviser par zéro. C’est toujours vérifié ici, puisque $q_\phi$ est choisie gaussienne, de support l’espace entier.
Reconnaître une espérance. Pour toute fonction $h(\mathbf{z})$ et toute distribution $q(\mathbf{z})$, la définition de l’espérance donne $\mathbb{E}{\mathbf{z} \sim q(\mathbf{z})}[h(\mathbf{z})] = \int h(\mathbf{z})\, q(\mathbf{z})\, d\mathbf{z}$. L’intégrale ci-dessus a exactement cette forme, avec $q(\mathbf{z}) = q\phi(\mathbf{z} \mid \mathbf{x})$ et $h(\mathbf{z}) = \dfrac{p_\theta(\mathbf{x} \mid \mathbf{z})\, p(\mathbf{z})}{q_\phi(\mathbf{z} \mid \mathbf{x})}$, donc :
\[p_\theta(\mathbf{x}) = \mathbb{E}_{\mathbf{z} \sim q_\phi(\mathbf{z} \mid \mathbf{x})}\!\left[ \frac{p_\theta(\mathbf{x} \mid \mathbf{z})\, p(\mathbf{z})}{q_\phi(\mathbf{z} \mid \mathbf{x})} \right].\]Passage au logarithme. Le logarithme s’applique aux deux membres d’une égalité sans en changer la validité, ce qui donne la forme annoncée :
\[\log p_\theta(\mathbf{x}) = \log \, \mathbb{E}_{\mathbf{z} \sim q_\phi(\mathbf{z} \mid \mathbf{x})}\!\left[ \frac{p_\theta(\mathbf{x} \mid \mathbf{z})\, p(\mathbf{z})}{q_\phi(\mathbf{z} \mid \mathbf{x})} \right].\]À ce stade, tout est encore exact, aucune approximation n’a été introduite : ces trois étapes ne font que faire apparaître une espérance sous $q_\phi$ à l’intérieur du logarithme. C’est cette forme précise, $\log\big(\mathbb{E}[\cdot]\big)$, que l’inégalité de Jensen va transformer en $\mathbb{E}[\log(\cdot)]$ dans le calcul qui suit, et c’est cette transformation-là, et elle seule, qui introduit l’approximation.
Donc allons-y, le logarithme est une fonction concave. L’inégalité de Jensen dont on vient de parler, dit que, pour une fonction concave $h$, $h(\mathbb{E}[X]) \geq \mathbb{E}[h(X)]$. Appliquée ici :
\[\log p_\theta(\mathbf{x}) \geq \mathbb{E}_{q_\phi(\mathbf{z} \mid \mathbf{x})}\!\left[ \log \frac{p_\theta(\mathbf{x} \mid \mathbf{z})\, p(\mathbf{z})}{q_\phi(\mathbf{z} \mid \mathbf{x})} \right] = \mathbb{E}_{q_\phi(\mathbf{z} \mid \mathbf{x})}\big[\log p_\theta(\mathbf{x} \mid \mathbf{z})\big] - \mathrm{KL}\big(q_\phi(\mathbf{z} \mid \mathbf{x}) \,\|\, p(\mathbf{z})\big).\]Le membre de droite est l’ELBO (Evidence Lower BOund), noté $\mathcal{L}(\theta, \phi; \mathbf{x})$ : une quantité qu’on sait calculer et dériver, et qui borne inférieurement la quantité qu’on voulait maximiser mais ne pouvait pas calculer.
On peut aussi montrer, sans passer par Jensen, l’égalité exacte suivante, qui donne un sens plus concret à cette borne (c’est l’équation 1 du papier de Kingma et Welling (2013)):
\[\log p_\theta(\mathbf{x}) = \mathcal{L}(\theta, \phi; \mathbf{x}) + \mathrm{KL}\big(q_\phi(\mathbf{z} \mid \mathbf{x}) \,\|\, p_\theta(\mathbf{z} \mid \mathbf{x})\big).\]Comme une divergence KL (Kullback-Leibler) est toujours positive ou nulle, cette égalité confirme que $\mathcal{L}$ est bien une borne inférieure de $\log p_\theta(\mathbf{x})$, et elle montre surtout ceci : à $\theta$ fixé, maximiser $\mathcal{L}$ par rapport à $\phi$ revient exactement à minimiser l’écart entre notre approximation $q_\phi(\mathbf{z} \mid \mathbf{x})$ et la vraie distribution a posteriori $p_\theta(\mathbf{z} \mid \mathbf{x})$, celle-là même qu’on ne savait pas calculer directement en section 3.
5. Mettons un peu de concret dans ces maths
Réécrivons l’ELBO tel qu’on le maximise en pratique, en cherchant à minimiser son opposé :
\[-\mathcal{L}(\theta, \phi; \mathbf{x}) = \underbrace{-\,\mathbb{E}_{q_\phi(\mathbf{z} \mid \mathbf{x})}\big[\log p_\theta(\mathbf{x} \mid \mathbf{z})\big]}_{\text{terme de reconstruction}} + \underbrace{\mathrm{KL}\big(q_\phi(\mathbf{z} \mid \mathbf{x}) \,\|\, p(\mathbf{z})\big)}_{\text{terme de régularisation}}.\]Le terme de reconstruction. $-\log p_\theta(\mathbf{x} \mid \mathbf{z})$ est la log-vraisemblance négative de $\mathbf{x}$ sous le décodeur. Si l’on suppose que $p_\theta(\mathbf{x} \mid \mathbf{z})$ est une gaussienne de variance fixe centrée sur la sortie du décodeur $g_\theta(\mathbf{z})$, ce terme se réduit, à une constante additive près qui ne dépend pas des paramètres, à l’erreur quadratique $|\mathbf{x} - g_\theta(\mathbf{z})|^2$, l’exacte perte de reconstruction du billet précédent. C’est ce choix de loi qui justifie, après coup, l’usage de la MSE dans le code.
En clair : ce terme mesure à quel point l’image reconstruite ressemble à l’originale, un peu comme comparer une photocopie à son document source. Plus la photocopie est fidèle, plus ce terme est petit.
Le terme de régularisation. $\mathrm{KL}(q_\phi(\mathbf{z} \mid \mathbf{x}) \,|\, p(\mathbf{z}))$ pénalise l’écart entre la distribution produite par l’encodeur pour $\mathbf{x}$ et la loi a priori $\mathcal{N}(0, I)$. C’est ce terme, absent de l’autoencodeur classique, qui force chaque distribution latente à rester proche d’une même gaussienne centrée réduite, garantissant qu’un $\mathbf{z}$ tiré depuis $\mathcal{N}(0, I)$ tombe dans une région que le décodeur a effectivement apprise. Ce terme, on le reconnaît, est un cas particulier du cadre général posé dans le billet précédent (section 9.2) : $\Omega(\mathbf{z}) = \mathrm{KL}(q_\phi(\mathbf{z} \mid \mathbf{x}) \,|\, p(\mathbf{z}))$.
En clair : ce terme empêche chaque image d’aller se ranger n’importe où dans l’espace latent, chacune dans son coin, loin des autres. Il les oblige à rester regroupées autour d’un même centre, un peu comme si on demandait à des élèves dispersés dans une cour de se rassembler tous près du même point plutôt que de se disperser dans les coins.
6. Paramétrer $q_\phi$ : l’encodeur produit une gaussienne
En pratique, on choisit $q_\phi(\mathbf{z} \mid \mathbf{x})$ gaussienne à covariance diagonale, $\mathcal{N}(\boldsymbol{\mu}(\mathbf{x}), \mathrm{diag}(\boldsymbol{\sigma}^2(\mathbf{x})))$, où $\boldsymbol{\mu}$ et $\boldsymbol{\sigma}^2$ sont les deux sorties de l’encodeur, deux vecteurs de même dimension que l’espace latent. Ce choix rend le terme de régularisation calculable sous forme close.
Pour deux gaussiennes $\mathcal{N}(\boldsymbol{\mu}, \mathrm{diag}(\boldsymbol{\sigma}^2))$ et $\mathcal{N}(0, I)$ de dimension $m$, la divergence KL générale entre deux gaussiennes multivariées,
\[\mathrm{KL}(\mathcal{N}(\boldsymbol{\mu}_1, \Sigma_1) \,\|\, \mathcal{N}(\boldsymbol{\mu}_2, \Sigma_2)) = \frac{1}{2}\left[ \mathrm{tr}(\Sigma_2^{-1}\Sigma_1) + (\boldsymbol{\mu}_2 - \boldsymbol{\mu}_1)^\top \Sigma_2^{-1} (\boldsymbol{\mu}_2 - \boldsymbol{\mu}_1) - m + \ln\frac{\det \Sigma_2}{\det \Sigma_1} \right],\]se simplifie, avec $\Sigma_1 = \mathrm{diag}(\boldsymbol{\sigma}^2)$, $\boldsymbol{\mu}_1 = \boldsymbol{\mu}$, $\Sigma_2 = I$, $\boldsymbol{\mu}_2 = 0$, en
\[\mathrm{KL}\big(q_\phi(\mathbf{z} \mid \mathbf{x}) \,\|\, p(\mathbf{z})\big) = \frac{1}{2} \sum_{j=1}^{m} \left( \sigma_j^2 + \mu_j^2 - 1 - \log \sigma_j^2 \right).\]C’est exactement la formule utilisée dans l’implémentation, et elle ne dépend d’aucune approximation supplémentaire : c’est une expression exacte, dérivée directement de la définition de la divergence KL entre deux gaussiennes.
On pourra se référer à l’annexe B de Kingma & Welling (2013) pour le détail complet de cette dérivation.
7. Le “reparametrization trick”
Il reste un obstacle avant de pouvoir entraîner ce modèle par descente de gradient : le terme de reconstruction de la section 5 demande de tirer $\mathbf{z} \sim q_\phi(\mathbf{z} \mid \mathbf{x})$, puis de calculer $\log p_\theta(\mathbf{x} \mid \mathbf{z})$. Mais l’opération de tirage aléatoire n’est pas une fonction différentiable de $\boldsymbol{\mu}$ et $\boldsymbol{\sigma}$ : on ne peut pas rétropropager un gradient à travers un échantillonnage.
Kingma & Welling (2013) et, indépendamment, Rezende, Mohamed & Wierstra (2014) résolvent ce problème en réécrivant le tirage comme une transformation déterministe d’une source de bruit fixe :
\[\mathbf{z} = \boldsymbol{\mu}(\mathbf{x}) + \boldsymbol{\sigma}(\mathbf{x}) \odot \boldsymbol{\varepsilon}, \qquad \boldsymbol{\varepsilon} \sim \mathcal{N}(0, I),\]où $\odot$ est le produit terme à terme. Le caractère aléatoire est désormais entièrement porté par $\boldsymbol{\varepsilon}$, qui ne dépend d’aucun paramètre entraînable. $\mathbf{z}$ devient une fonction déterministe et différentiable de $\boldsymbol{\mu}$ et $\boldsymbol{\sigma}$, à $\boldsymbol{\varepsilon}$ fixé, ce qui permet à la descente de gradient de traverser normalement l’opération d’échantillonnage.
En mode évaluation, on utilise directement $\mathbf{z} = \boldsymbol{\mu}(\mathbf{x})$, sans tirage : c’est la meilleure estimation ponctuelle disponible, celle qui maximise $q_\phi(\mathbf{z} \mid \mathbf{x})$.
8. Un peu de code
Comme pour l’autoencodeur, on implémente un encodeur et un décodeur. La seule différence structurelle : l’encodeur produit maintenant deux vecteurs, $\boldsymbol{\mu}$ et $\log \boldsymbol{\sigma}^2$, plutôt qu’un seul $\mathbf{z}$. Note qu’on prédit le logarithme de la variance plutôt que la variance elle-même pour que la sortie du réseau, non contrainte en signe, puisse représenter n’importe quelle variance positive une fois exponentiée.
Attention, c’est une implémentation très simple pour illustrer mon propos. Libre à chacun d’augmenter le nombre de couches, de modifier les fonctions d’activation…
import torch
import torch.nn as nn


class Encoder(nn.Module):
    """Convolutional encoder producing the parameters of q(z|x)."""

    def __init__(self, latent_dim):
        super().__init__()
        self.conv = nn.Sequential(
            nn.Conv2d(1, 32, kernel_size=3, stride=2, padding=1),
            nn.ReLU(),
            nn.Conv2d(32, 64, kernel_size=3, stride=2, padding=1),
            nn.ReLU(),
        )
        self.fc_mu = nn.Linear(64 * 7 * 7, latent_dim)
        self.fc_logvar = nn.Linear(64 * 7 * 7, latent_dim)

    def forward(self, x):
        h = self.conv(x)
        h = h.flatten(start_dim=1)
        mu = self.fc_mu(h)
        logvar = self.fc_logvar(h)
        return mu, logvar


class Decoder(nn.Module):
    """Convolutional decoder mapping a latent sample back to an image."""

    def __init__(self, latent_dim):
        super().__init__()
        self.fc = nn.Linear(latent_dim, 64 * 7 * 7)
        self.deconv = nn.Sequential(
            nn.ConvTranspose2d(64, 32, kernel_size=3, stride=2, padding=1, output_padding=1),
            nn.ReLU(),
            nn.ConvTranspose2d(32, 1, kernel_size=3, stride=2, padding=1, output_padding=1),
            nn.Sigmoid(),
        )

    def forward(self, z):
        h = self.fc(z)
        h = h.view(-1, 64, 7, 7)
        x_hat = self.deconv(h)
        return x_hat


class VAE(nn.Module):
    """Variational autoencoder combining a separately defined encoder and decoder."""

    def __init__(self, latent_dim):
        super().__init__()
        self.encoder = Encoder(latent_dim)
        self.decoder = Decoder(latent_dim)

    def reparameterize(self, mu, logvar):
        """Sample z via the reparametrization trick."""
        std = torch.exp(0.5 * logvar)
        eps = torch.randn_like(std)
        return mu + std * eps

    def forward(self, x):
        mu, logvar = self.encoder(x)
        z = self.reparameterize(mu, logvar)
        x_hat = self.decoder(z)
        return x_hat, mu, logvar


def vae_loss(x, x_hat, mu, logvar):
    """Return the negative ELBO, reconstruction plus KL term."""
    recon = nn.functional.mse_loss(x_hat, x, reduction="sum")
    kl = 0.5 * torch.sum(logvar.exp() + mu.pow(2) - 1 - logvar)
    return recon + kl
9. Générer une nouvelle donnée
C’est ici que la section 8 du billet précédent trouve sa réponse. Pour générer une donnée jamais vue, on n’a plus besoin de l’encodeur du tout :
- tirer $\mathbf{z} \sim \mathcal{N}(0, I)$
- calculer $\hat{\mathbf{x}} = g_\theta(\mathbf{z})$, le décodeur seul
Parce que le terme KL de la section 5 a forcé, pendant l’entraînement, la distribution agrégée des $q_\phi(\mathbf{z} \mid \mathbf{x})$ sur tout le jeu de données à rester proche de $\mathcal{N}(0, I)$, un tirage direct depuis $\mathcal{N}(0, I)$ tombe, avec une probabilité bien plus élevée que dans le cas de l’autoencodeur, dans une région que le décodeur a effectivement apprise.
10. Quelques résultats avec FashionMNIST
J’ai repris le même dataset que pour l’autoencodeur et j’ai modifié l’architecture du réseau, comme on peut le voir dans la section 8.
Comparaison des reconstructions entre AE et VAE
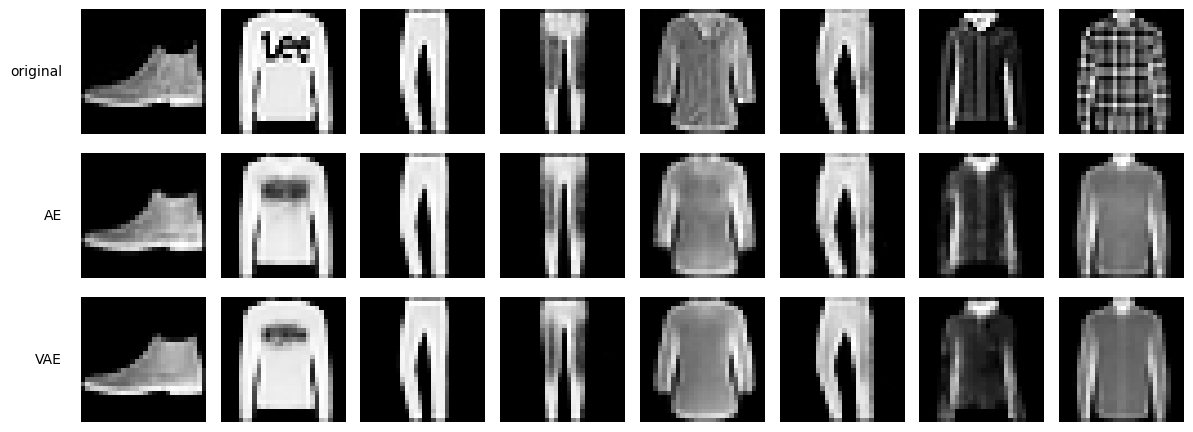
La silhouette et la catégorie de chaque vêtement sont fidèlement reconstruites par les deux modèles. Le détail fin commence aussi à réapparaître : le texte « Lee » sur le pull redevient partiellement lisible, et le motif à carreaux de la dernière chemise conserve sa structure quadrillée plutôt que de se réduire à un aplat gris uniforme. La limite reste néanmoins visible, le logo est reconnaissable mais pas net, une conséquence directe de la perte de reconstruction utilisée (section 5) : la MSE pénalise l’écart pixel à pixel et favorise, pour un détail à haute fréquence comme un motif répétitif ou un texte, une version moyenne plutôt qu’un rendu net.
Comparaison des espaces latents
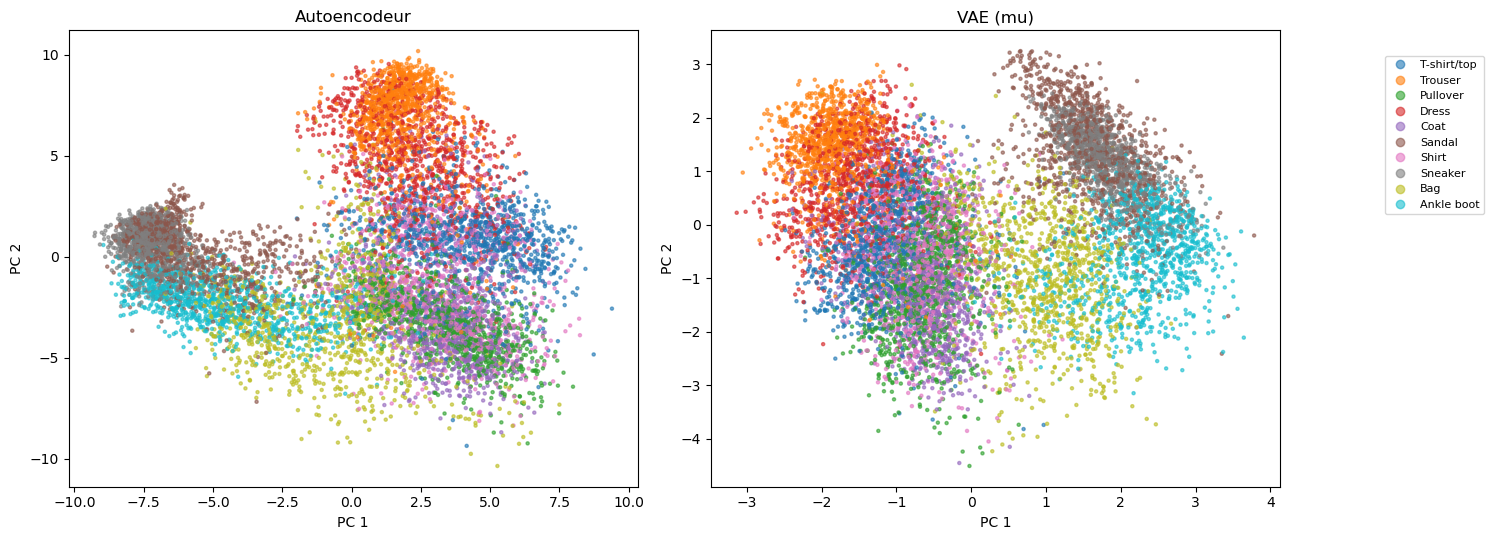
Sans jamais avoir vu les étiquettes de classe pendant l’entraînement, les deux modèles organisent l’espace latent de façon très similaire : le pantalon (orange) et la robe (rouge) forment une zone distincte, les chaussures (sandale, sneaker, bottine) se regroupent d’un côté, et les hauts du corps (T-shirt, pull, manteau, chemise) se mélangent au centre, leurs silhouettes générales étant trop proches pour se séparer nettement. La différence la plus visible entre les deux graphiques est l’échelle des axes, environ deux fois plus resserrée pour le VAE que pour l’AE. C’est la signature directe du terme de régularisation KL (section 5) : il pousse la distribution latente de chaque image vers une gaussienne centrée réduite, ce qui contraint mécaniquement l’étendue totale de l’espace, une contrainte que l’autoencodeur classique n’a pas.
Tirage aléatoire dans l’espace latent
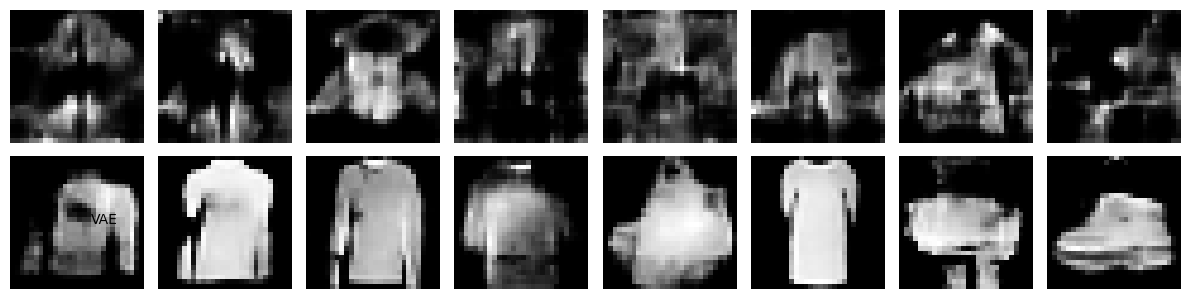
On voit ici ce qui distingue vraiment un autoencodeur d’un modèle génératif. La ligne AE ne produit que des formes assez incohérentes. La ligne VAE, à l’inverse, produit des vêtements plausibles et variés, T-shirts, robe, sac, chaussure, sans jamais passer par une image réelle. C’est exactement ce que garantit le terme KL : en forçant la distribution latente de chaque donnée d’entraînement à rester proche de $\mathcal{N}(0, I)$, il rend cette même loi utilisable comme point de départ fiable pour générer de nouvelles données, l’expérience illustrée par la figure de Foster (2023) en ouverture en haut de ce billet.
Références
-
Foster, D., Generative Deep Learning, O’Reilly, 2019, 1ère édition.
-
Kingma, D. P., & Welling, M. (2013). Auto-Encoding Variational Bayes. ICLR 2014. arXiv:1312.6114
-
Rezende, D. J., Mohamed, S., & Wierstra, D. (2014). Stochastic Backpropagation and Approximate Inference in Deep Generative Models. Proceedings of the 31st International Conference on Machine Learning (ICML), PMLR 32(2), 1278-1286. arXiv:1401.4082
-
Wikipedia, Inégalité de Jensen. https://fr.wikipedia.org/wiki/In%C3%A9galit%C3%A9_de_Jensen
Enjoy Reading This Article?
Here are some more articles you might like to read next: